Nueve meses después de su lanzamiento, Latam-GPT, el modelo de lenguaje latinoamericano que lidera el Centro Nacional de Inteligencia Artificial (CENIA) desde Chile, tiene sus pesos publicados para descarga, dos pruebas propias para medir cuánto saben las IA sobre la región y un nuevo socio: Microsoft, que el 28 de octubre de 2026 comprometió 250 mil dólares en créditos de nube para mantenerlo funcionando. Las fuentes revisadas al 15 de noviembre no permiten confirmar si el supercomputador anunciado para entrenar versiones futuras ya está operativo.
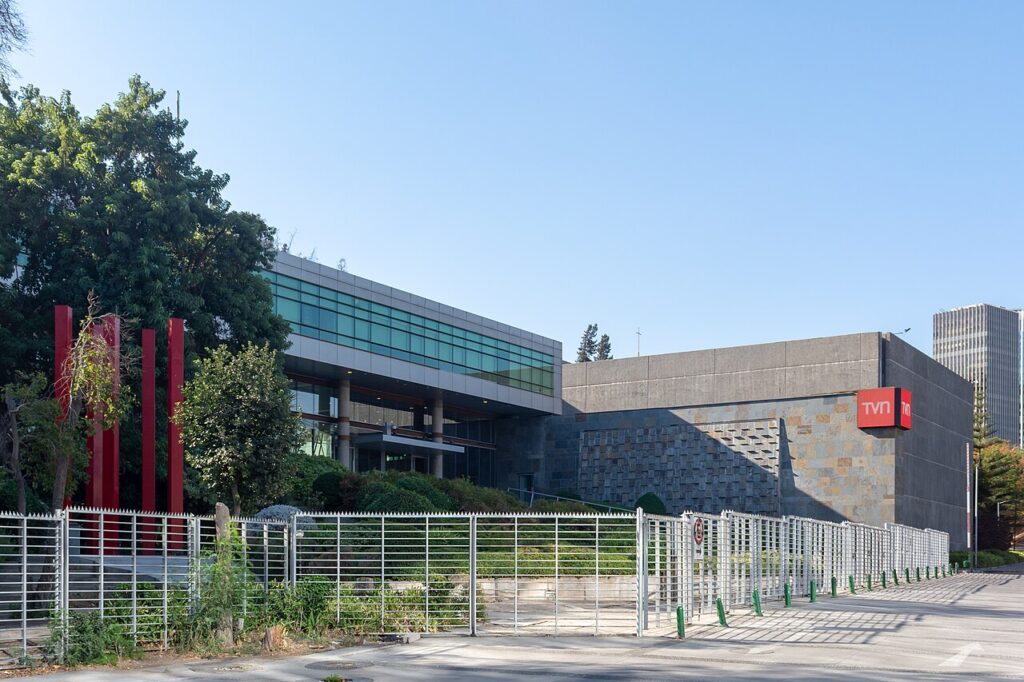
El modelo se presentó el 10 de febrero de 2026 en los estudios de TVN, con la participación del entonces Presidente Gabriel Boric. Entre sus apoyos estuvieron CAF, la cartera de Ciencia, AWS y Data Observatory, y se entrenó con más de ocho terabytes de información. En la ceremonia, Boric vinculó la iniciativa con la representación de la identidad regional en el lenguaje.
Qué es y qué no es. Latam-GPT no es un chatbot para el público, sino una infraestructura base sobre la que universidades, servicios públicos y empresas pueden construir sus propias aplicaciones. Técnicamente, no se entrenó desde cero. La ficha publicada en Hugging Face indica que la versión 1.0 parte del modelo Llama 3.1 de 70 mil millones de parámetros, de Meta, y lo adapta en dos etapas: un preentrenamiento continuado con datos latinoamericanos y un ajuste supervisado para seguir instrucciones y conversar en español, portugués e inglés. Al corte de esta revisión, el repositorio oficial permite acceder a los pesos. La fecha de creación de un repositorio no basta para establecer cuándo se publicaron sus archivos actuales.
Ese origen tiene consecuencias. Aunque CENIA lo describe como un modelo abierto, su uso queda sujeto a la licencia comunitaria de Llama 3.1, de Meta, y no a una licencia de código abierto tradicional, según la misma ficha de Hugging Face, que recomienda revisar esos términos antes de redistribuirlo o llevarlo a producción. La ficha también advierte que un catálogo de datos y un informe técnico "se publicarán pronto", y que los pesos ocupan alrededor de 140 GB de memoria de video en precisión BF16 o FP16; el consumo total de ejecución es mayor y depende de la configuración.
Cuánto costó. De acuerdo con la agencia AFP, el desarrollo costó unos 550 mil dólares, financiados principalmente por CAF y con recursos propios de CENIA. En el mismo reportaje, el académico de la Universidad de Chile Alejandro Barros advirtió que, con ese presupuesto, el modelo no tiene posibilidad de competir con los grandes modelos comerciales; sus propios impulsores reconocen que no compite en escala. La apuesta, según CENIA, es otra: el español representa cerca del 4% de los datos con que se entrenan los grandes modelos, y la región quiere uno que conozca sus usos, lugares y referencias.
Cómo se mide. En abril, CENIA presentó dos pruebas abiertas para evaluar ese conocimiento regional. Trueque reúne preguntas curadas por contrapartes de 20 países sobre temas, dialectos y dichos, y Choclo suma 10.000 preguntas sobre 18 países construidas a partir de Wikipedia. Según el centro, los modelos comerciales y abiertos evaluados no superaron en promedio 0,48 puntos sobre 1. Según CENIA, las licencias de esos conjuntos son MIT y Apache 2.0; esta revisión no auditó sus archivos ni la metodología del puntaje.
Quiénes participan. CENIA habla de unas 60 instituciones de 15 países en su comunicado de octubre y de más de 65 instituciones y cerca de 200 profesionales en el de junio, cuando el proyecto ganó tres premios en el certamen Mobile Time Selection, en São Paulo. Según el comunicado de octubre, el corpus supera los 300 mil millones de tokens en español y portugués.
La alianza con Microsoft. El memorando, firmado por Juan Lavista Ferres, de Microsoft, y Álvaro Soto, entonces director de CENIA, fija un marco de cooperación por dos años. Incluye 250 mil dólares en créditos de Azure hasta febrero de 2027 para infraestructura y operación, asesoría del AI for Good Lab y casos de estudio en educación, servicios públicos y salud. CENIA informó que su operación actual se sostiene con infraestructura de nube. Esto describe el despliegue del centro y no impide que terceros descarguen los pesos para ejecutarlos en otro equipo.
El supercomputador pendiente. En febrero, el anuncio fue que las siguientes versiones se entrenarían en un supercomputador instalado en la Universidad de Tarapacá, en Arica, con una inversión cercana a cinco millones de dólares, según 24 Horas. A noviembre, los comunicados de CENIA siguen describiendo un modelo que opera en la nube, y no fue posible confirmar con fuentes públicas que el equipo de Tarapacá ya esté entrenando una versión 2.0.
Qué significa para Chile. El desarrollo de Latam-GPT continuó después del cambio de gobierno de marzo: el Ministerio de Ciencia que lo lanzó con el exministro Aldo Valle hoy lo encabeza Ximena Lincolao, y CENIA cambió de director el 2 de noviembre, según el anuncio institucional de asunción de Pablo Barceló, que mantuvo a Latam-GPT entre sus prioridades. Para un desarrollador chileno, la noticia práctica es que el modelo se puede descargar y adaptar, siempre que acepte la licencia de Meta y disponga del hardware para moverlo.